Vocabulaire de l’IA : comprendre les tokens
Vous voyez des mots. L’IA traite des briques de texte : les tokens. Une explication simple de leur rôle, de leurs limites et de leur utilité.
- Thème
- IA & automatisation
- Auteur
- Arnaud Siou
- Publié le
- Lecture
- 3 min de lecture
Vous voyez une phrase. L’IA voit des briques.
C’est l’idée derrière les tokens. Quand vous écrivez une phrase, vous voyez naturellement des mots et du sens. Un modèle de langage, lui, reçoit votre texte sous la forme de petits morceaux appelés tokens.
Après les quatre notions pour comprendre les bases de l’IA, ce deuxième volet propose de découvrir ces briques de texte et ce qu’elles changent dans l’utilisation des assistants conversationnels.
Un token : une brique de texte
Imaginez des LEGO. Vous voyez la construction finale. Le modèle, lui, traite d’abord les briques qui la composent.
Un token peut correspondre à :
- un mot entier ;
- une partie de mot ;
- un signe de ponctuation ;
- un espace associé à un fragment de texte, ou un autre petit morceau.
Ce découpage s’appelle la tokenisation. Il est réalisé par un outil appelé tokenizer, avant que le texte soit traité par le modèle. Chaque token est associé à un identifiant numérique.
Un token n’est donc pas forcément un mot, ni une lettre. C’est une unité de texte dont la taille varie selon le tokenizer et le contenu.
« Incompréhensible » : un mot, plusieurs briques
Prenons le mot « incompréhensible ».
Pour nous, c’est un seul mot. Pour un modèle, il peut être représenté par plusieurs tokens.
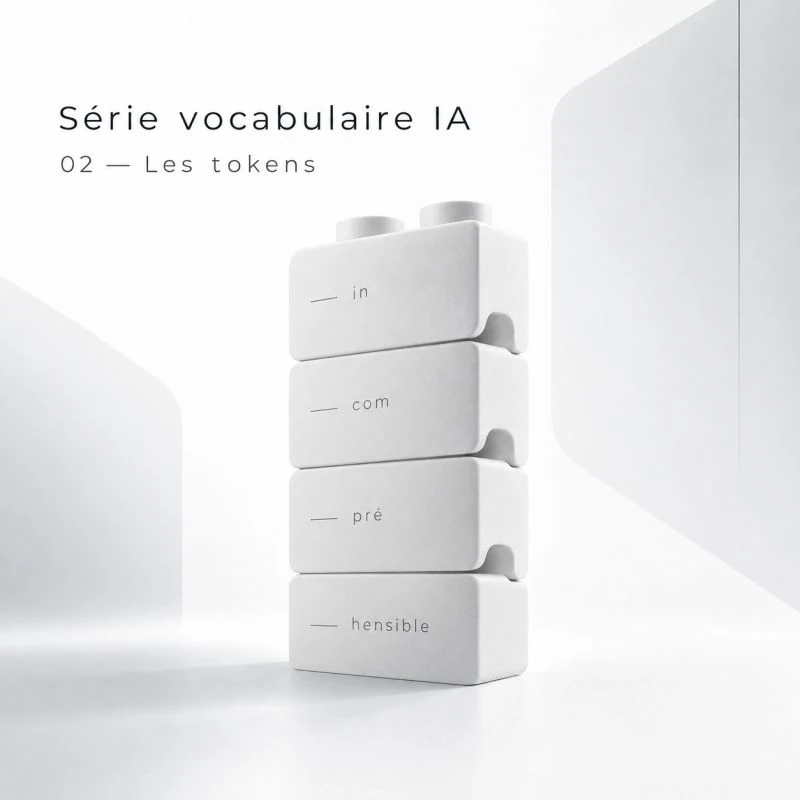
Le visuel de cet article le montre sous la forme de quatre briques : « in », « com », « pré » et « hensible ». C’est une illustration du principe, pas le résultat vérifié d’un tokenizer précis.
Le découpage réel peut être différent d’un modèle à l’autre. Il ne suit pas nécessairement les syllabes ou les éléments que nous repérons en lisant.
En pratique, le nombre de mots ne suffit pas à connaître le nombre de tokens. La langue, les accents, la ponctuation et le tokenizer utilisé peuvent modifier ce nombre.
Pourquoi compter des lettres peut poser problème
Un assistant peut expliquer un sujet complexe et parfois se tromper sur une question qui nous paraît simple : « Combien y a-t-il de lettres i dans le mot incompréhensible ? »
La réponse est deux : un « i » au début du mot et un autre dans la terminaison « sible ».
Mais les unités reçues par le modèle ne correspondent pas nécessairement aux lettres prises une par une. Compter précisément les caractères demande donc une opération différente de celle qui consiste à produire une explication fluide.
La tokenisation contribue à expliquer cette difficulté, sans être la seule cause des erreurs. Les capacités du modèle, son entraînement et la méthode utilisée comptent aussi.
Les anagrammes, certains jeux de mots et les mots croisés peuvent poser des difficultés similaires lorsqu’ils exigent de manipuler exactement les lettres. Cela ne signifie pas qu’un modèle échoue toujours : il peut réussir, et un assistant équipé d’un programme peut vérifier le résultat.
En pratique, pour un comptage exact, utilisez une méthode vérifiable, comme un petit script, plutôt que de vous fier uniquement à une réponse formulée avec assurance.
Les tokens servent aussi de compteur
Les tokens permettent de mesurer la quantité de texte qu’un modèle reçoit et génère.
Ils interviennent notamment dans :
- le contexte disponible : la quantité de texte que le modèle peut prendre en compte à un instant donné ;
- la longueur des réponses : certaines limites sont exprimées en tokens ;
- le coût d’utilisation via une API : de nombreux services distinguent les tokens en entrée et ceux en sortie.
Le contexte peut inclure votre demande, l’historique de la conversation, des instructions et des documents fournis à l’assistant. Une courte question accompagnée d’un long document peut donc représenter beaucoup de tokens.
En pratique, fournissez les informations utiles et évitez les répétitions inutiles. L’objectif est de donner au modèle assez de contexte pour répondre à votre besoin.
À retenir : des mots pour nous, des briques pour le modèle
Vous voyez des mots. Le modèle traite d’abord des unités de texte : les tokens.
L’image des LEGO aide à retenir le principe : les briques ne correspondent pas toujours aux mots ou aux lettres que nous distinguons. Elles servent à représenter le texte et à mesurer la quantité traitée.
Vocabulaire IA #2 : débloqué.
Pour approfondir le découpage du texte, consultez la documentation des tokenizers de Hugging Face et sa présentation des algorithmes de tokenisation.